İçindekiler 4
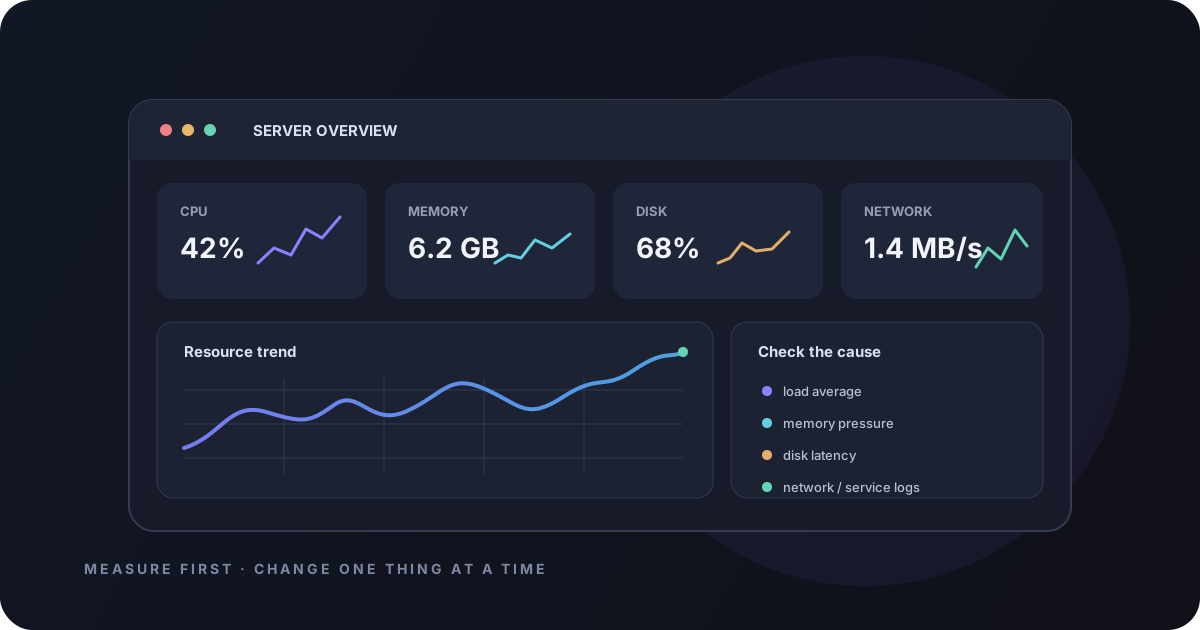
Linux sunucuda yavaşlık yaşandığında ilk adım rastgele servis kapatmak değil, hangi kaynağın darboğaz oluşturduğunu ölçmektir. CPU, bellek, disk ve ağ belirtileri birbirine benzeyebilir; tek bir anlık ölçüm yerine sorun yaşandığı sıradaki verileri ve değişiklik geçmişini birlikte değerlendirin.
İlk kontrol için temel komutlar
uptime
top
free -h
df -h
df -i
ss -suptimeçalışma süresini ve load average değerlerini gösterir. Load average CPU kullanımı yüzdesi değildir; işlem bekleyen işleri de içerir. CPU sayısı ve iş yüküyle birlikte yorumlayın.topçalışan süreçleri ve canlı CPU/bellek kullanımını gösterir. Tek bir yüksek kullanım değeri yerine, hangi süreçlerin ne kadar süre kaynak kullandığına bakın.free -hbellek ve swap durumunu özetler. Linux'un dosya önbelleği için RAM kullanması tek başına bellek yetersizliği anlamına gelmez; kullanılabilir bellek ve swap hareketini birlikte değerlendirin.df -hdosya sistemindeki boş alanı;df -iise inode kullanımını gösterir. Diskte gigabaytlarca boş yer olsa bile inode tükenmesi yeni dosya oluşturmayı engelleyebilir.ss -ssoket bağlantılarına dair özet verir; beklenmeyen bağlantı artışlarını uygulama ve firewall kayıtlarıyla karşılaştırın.
Disk ve sistem günlüklerini inceleyin
Yüksek disk kullanımı, dolu dosya sistemiyle aynı sorun değildir. Uygulama günlükleri, geçici dosyalar, veritabanı yazımları ve depolama gecikmesi farklı kontroller gerektirir. Dağıtımınızda mevcutsa iostat aracıyla cihaz başına I/O değerlerini de gözlemleyebilirsiniz. Sistem uyarılarını görmek için:
sudo journalctl -p warning -b --no-pagerKomut çıktısını zaman aralığıyla ve ilgili servis günlükleriyle karşılaştırın. Logları paylaşmadan önce IP, kullanıcı adı, alan adı ve erişim belirteci gibi hassas değerleri temizleyin.
Ölçümü anlamlı hale getirin
- Yavaşlığın başladığı zamanı, etkilenen servisi ve yapılan son değişiklikleri kaydedin.
- Kaynakları sorun anında ve normal çalışma döneminde karşılaştırın; sürekli veya tekrarlayan örüntü arayın.
- CPU, RAM, disk gecikmesi ve ağ ölçümlerini aynı zaman aralığında inceleyin. Uygulama günlükleriyle eşleştirin.
- Bir seferde tek değişiklik yapıp etkisini tekrar ölçün. Ölçüm olmadan kaynak yükseltmek veya servisi yeniden başlatmak asıl nedeni gizleyebilir.
İzleme ve alarm planı
Uzun vadeli kapasite planlaması için metrikleri zaman serisi halinde tutan bir izleme sistemi kullanın. Alarm eşiğini doğrudan tek bir sabit değere bağlamak yerine hizmetin normal davranışına, ölçüm süresine ve iş etkisine göre belirleyin. Disk alanı, inode, yedekleme sonucu ve servis erişilebilirliği için ayrı uyarılar planlayın.
Yeni Linux sunucunun başlangıç yapılandırması için Linux VDS güvenlik rehberini, yedekleme durumunu doğrulamak için geri yükleme testi rehberini inceleyebilirsiniz.